具身智能下半场:数据“炼油厂”正在成为新基础设施
 2026-08-31 22:20
来源:华鸿智数
近日,航天鸿翼(重庆)先进存力中心与AI数智产业生态大会在重庆举行。华鸿智数(深圳)数字科技有限公司副总裁、具身智能数采事业群负责人陈奇围绕"具身智能数据"进行了主题分享。
这场分享勾勒出整个具身智能产业正在发生的底层变化:当模型与算法的竞争进入深水区,决定机器人能不能真正“干活”的,已经不再是实验室里的跑分,而是真实场景中高质量数据的供给能力。
具身智能的瓶颈,正从“算法”转向“数据”
传统AI的输入输出相对封闭,而具身智能机器人必须在真实的物理空间中理解环境、连续执行动作,场地约束与目标导向都更加苛刻。陈奇明确指出:这需要数量级更大、多样性更高的数据来支撑训练。
其中一处细节颇具启示意义:美国企业开展机器人训练时,会将产线传送带运转速度、环境实时气温,乃至超市各类货品的体积、重量等信息全部纳入模型训练数据集。这也折射出具身智能行业的现实发展趋势,其数据采集模式正从 “实验室摆拍” 转向真实生产场景下的全要素采集。海量来自现实场景的多维数据,也成为决定具身智能产品落地能力的核心变量。
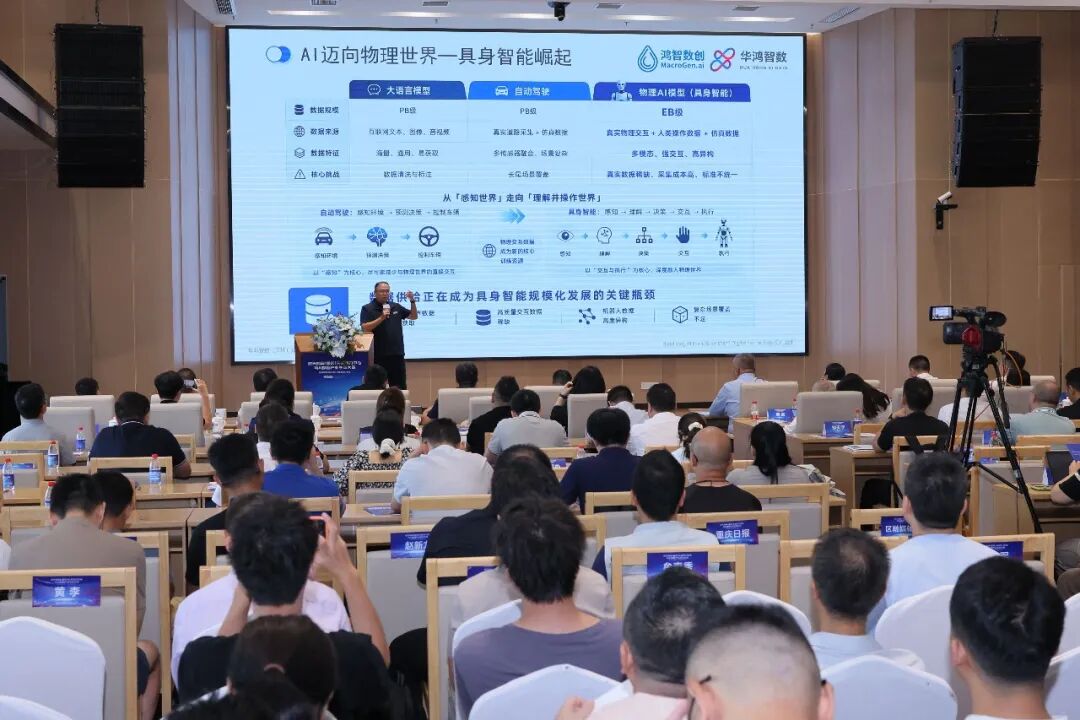 图:华鸿智数副总裁、具身智能数采事业群负责人陈奇
如果说互联网文本数据是大型语言模型的“养料”,那么机器人的训练数据至今仍没有成规模、成体系的现成来源。“数据稀缺”,已成为制约具身智能商业化落地的第一性约束。谁能率先建立稳定的高质量数据供给,谁就掌握了产业化的入场券。
什么才是高质量数据?陈奇给出了一个可供行业参照的坐标系:
一是真实场景。真实场景采集是首要条件——仿真数据再“干净”,也替代不了真实物理环境的物理反馈。
二是多模态融合。视觉、动作、力觉等模态的融合,才能支撑机器人对复杂环境的整体理解。
三是标准化。数据必须经过标准化处理,才能提高效率、直接用于模型训练。
四是要直面悖论。越真实,采集成本越高、数据专用性越强。行业需要在真实性与成本之间做工程化的折中,而非一味追求“最真实”或“最便宜”。
落到产业实践层面,这套评判标准意味着:衡量数据资产的价值,不能只看 “量”,更要看 “真不真、融不融、标不标准”。数据采集项目的 ROI 设计、质量分级管理,将成为每一家具身智能企业都必须补上的基本功。
“数据炼油厂”模式:数据产业的专业分工正在成型
用一个非常贴切的比喻:华鸿智数的能力,就是把数据这一“原油”加工为高质量的“成品”。
原始数据是“原油”;采集、审核、标注、标准化是“炼化”环节;输出标准数据集、定制格式、小模型与技能包,则是“成品”。这套“数据炼油厂”逻辑背后,是具身智能数据产业专业分工的成型:数据采集商、数据加工商、数据服务商、整机厂商与场景方各司其职,数据不再只是“附带品”,而是独立定价、独立交易的产业要素。
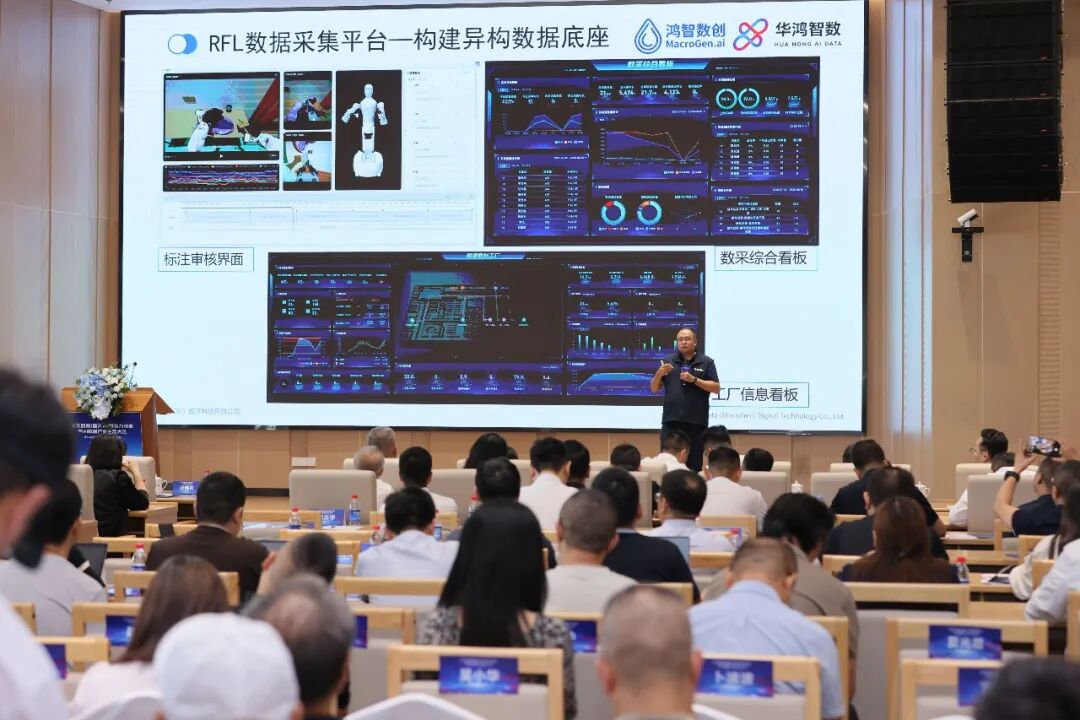 图:陈奇介绍RFL数据采集平台
反映在产业层面,生态结构将迎来加速分化:机器人整机厂不必再自建重资产数据团队,可以按需采购专业化数据服务;落到企业选型的实操层面,评估数据供应商的核心不再是 “矿藏储量”,而是“炼化能力”—— 能否把原始数据加工成模型可直接使用的训练资源。
而这套“数据炼油”的产业逻辑,并非停留在理论层面,已经落地为可规模化运转的能力。鸿智数创超级工厂展现出可观的数据产能:其业务覆盖15个以上行业主流场景,构建由125台真机构成的数据采集矩阵,整体存力达40P,包含本地10PB、云上30PB存储资源。项目启动以来,已累计采集7635小时真机数据,10月有效采集小时数即将突破1万小时,预计到明年同期,真机数据储备将达到10万小时(不包含Ego与UMI数据)。
数据产能是典型的“时间复利”型资产。超级工厂的规模化效应,将显著摊薄单位数据成本,并沉淀出难以复制的场景覆盖度与数据飞轮——后来者即便拥有同样的资金,也难以在短期内补齐数万小时的场景积累。这正是数据基础设施的“护城河”所在。
对于从业者而言:衡量一家数据服务商的实力,要看“有效数据小时数”等硬指标,而非名义数据量;同时,场景覆盖的广度直接决定模型的泛化能力上限,头部玩家的优势会随时间指数级放大。
值得关注的另一个信号,是华鸿智数正在从“交付数据”走向“交付能力”:基于数据资产训练小模型与技能包——让机器人清理试管、整理实验设备、在餐厅收集碗筷、在卧室整理床铺,未来以技能包形式与整机厂商合作落地。
当“技能包”成为可复制、可分发、可定价的产品,具身智能数据服务商的价值链将显著上移,甚至可能演化出类似“机器人技能商店”的分发形态。对从业者而言,这意味着数据采集不只是“人力密集”的苦活,更是通向模型服务与技能资产的战略入口。
数据出海与可信数据空间:中国数据服务商的新机会
陈奇透露,华鸿智数已与阿联酋头部科技公司G42正式签约,承接其旗下生物实验室1000小时的数据采集项目,每小时单价接近200美元。
图:陈奇分享主题
这是一次颇具象征意义的数据出海:一方面,它以接近200美元/小时的高客单价,验证了中国数据采集与处理能力在国际市场的竞争力;另一方面,生物实验室数据意味着极高的合规与可信要求,“敢接、能接、接得住”,本身就是对服务商能力的一次背书。
放回华鸿智数(深圳)数字科技有限公司的坐标系里,其业务价值可以概括为三点:
其一,全链条稀缺性。华鸿智数是数据采集细分赛道中少数具备“调研设计—设备选型—落地建设—运营—商业闭环”完整能力的公司,从“数据原油”到“数据成品”的一站式加工,降低了客户的供应链管理成本。
其二,平台化底座。自研RFL数据采集平台兼容真机采集、本体数据、Ego第一人称三种主流数据形态,并集后处理、标注审核、数据看板、数字孪生于一体,本质是一套“数据生产管理系统”;叠加自研算力平台与超级工厂的规模化产能,形成了“采集—处理—训练”的一体化技术支撑。
其三,三种交付形态与生态姿态。轻量化平台交付、“平台+服务”赋能同行、联合整机厂商推进应用落地,辅以数据出海与可信数据空间的前瞻布局——华鸿智数正在从“数据服务商”向“具身智能数据基础设施平台”演进。
结语
具身智能的竞争,正从"模型智商战"进入“数据基础设施战”。谁能把数据“原油”高效炼成高质量“成品”,谁就握住了机器人产业落地的“石油”。
(来源:华鸿智数)
声明:本文由21财经客户端“南财号”平台入驻机构(自媒体)发布,不代表21财经客户端的观点和立场。