华为 “超节点 + 集群”,构筑面向百万亿大模型的算力底座
来源:中国经营报
全球AI 产业的算力焦虑正在催生新的技术变革。当前全球AI产业进入高速迭代期,大模型参数、智能体能力、算力需求呈指数级增长,传统算力架构的通信瓶颈、利用率偏低、功耗过高等问题全面凸显。面向智能世界加速到来带来的算力需求,超节点已成为产、学、研共识,是建设超大规模AI基础设施的必然选择。
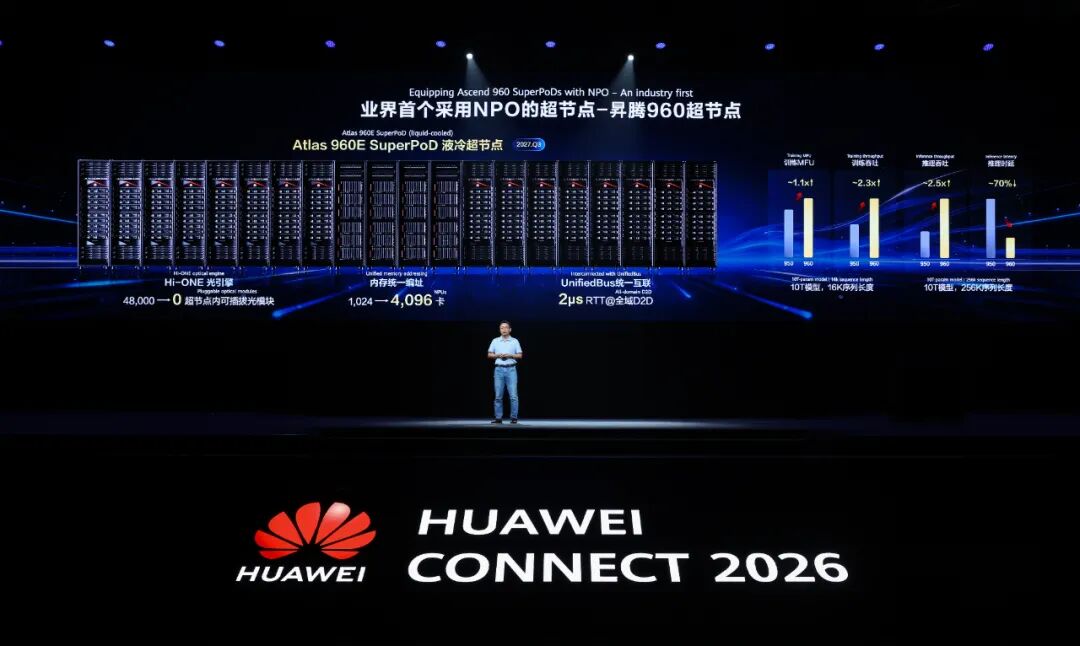
9 月 17 日,华为全联接大会 2026 在上海启幕,华为副董事长、轮值董事长汪涛发表题为“智启新未来,打造智能世界的硅基黑土地”的主题演讲,发布全球首个采用NPO技术的超节点——昇腾960超节点,加速十万亿规模的大模型训练和推理。
算力需求爆发
超节点成产业破局共识
AI 产业的爆发式增长,正在让全球陷入前所未有的算力供需矛盾。当前,大模型参数规模正快速迈向十万亿级,预计到 2030 年将突破百万亿;智能体的任务执行周期已从小时级迈向月级,每日推理 Token 量也将从当前的 500 万亿增长至百万万亿级。与此同时,端侧智能也在快速升级,手机端模型已从 2024 年的 3B 跃升至当前的 30B,未来还将进一步向 100B 级演进。这些翻天覆地的变化,正在对 AI 基础设施的规模、性能与可靠性提出前所未有的挑战。
传统服务器架构下,10 万卡集群内的通信开销已超过训练时间的 40%,这直接推高了超算集群的部署与运营成本,也严重制约了模型浮点算力利用率(MFU),成为超大规模 AI 发展的核心瓶颈。面对这一行业共性难题,超节点架构正在成为整个产业的破局方向,如今已成为产、学、研领域的共识,更是建设超大规模 AI 基础设施的必然选择。
汪涛对此解释道:“超节点是一种在物理上由多个计算节点通过高效的互联协议紧密连接组成,具备跨物理节点统一内存编址能力,逻辑上具备‘一台计算机’特征的计算系统。” 根据华为马尔科夫实验室的仿真结果,由 4K 超节点组成的 10 万卡集群,相比传统 8 卡服务器组成的同规模集群,MFU 可提升 2.75 倍,能够大幅释放算力潜力,提升企业的算力投入产出比。
而这一架构的商用价值也早已得到市场验证,截至目前,昇腾910C 超节点已部署超 1000 套,昇腾 950 超节点也已实现规模商用,超节点正在成为行业共同的技术演进方向。
架构技术破局
百万卡集群打开算力天花板
为了进一步突破超节点的互联瓶颈,华为推出了业界首个可量产的NPO(Near-Packaged Optics,近封装光学)光引擎产品 ——Hi-ONE。作为目前行业内传输能力最大的 NPO 产品之一,Hi-ONE 单引擎传输容量达到 7.2T,同时也是全球仅有的实现内置光源的NPO 产品,从底层解决了超大规模集群的互联成本与功耗难题。
通过光、机、电、磁、热等要素的均衡设计,Hi-ONE 将 “高带宽、高可靠” 与 “低时延、低功耗” 完美融合,与灵衢 UnifiedBus 协议共同构建起可规模扩展的超节点互联系统。与此同时,华为已在全球光互联标准组织 OIF 提出 NPO 标准立项建议,获得了行业伙伴的广泛响应,共同推动 NPO 产业生态的完善。
华为推出的NPO近封装光学技术,并非简单的单点硬件迭代,而是AI算力光互联体系面向规模化商用的务实升级。它将光引擎近距离部署在算力板卡上,大幅缩短高速电信号的传输路径,在性能、功耗、集成度等多个维度实现系统性优化,同时完全兼容现有数据中心的运维体系,最大程度延续了客户的使用习惯和产业生态。
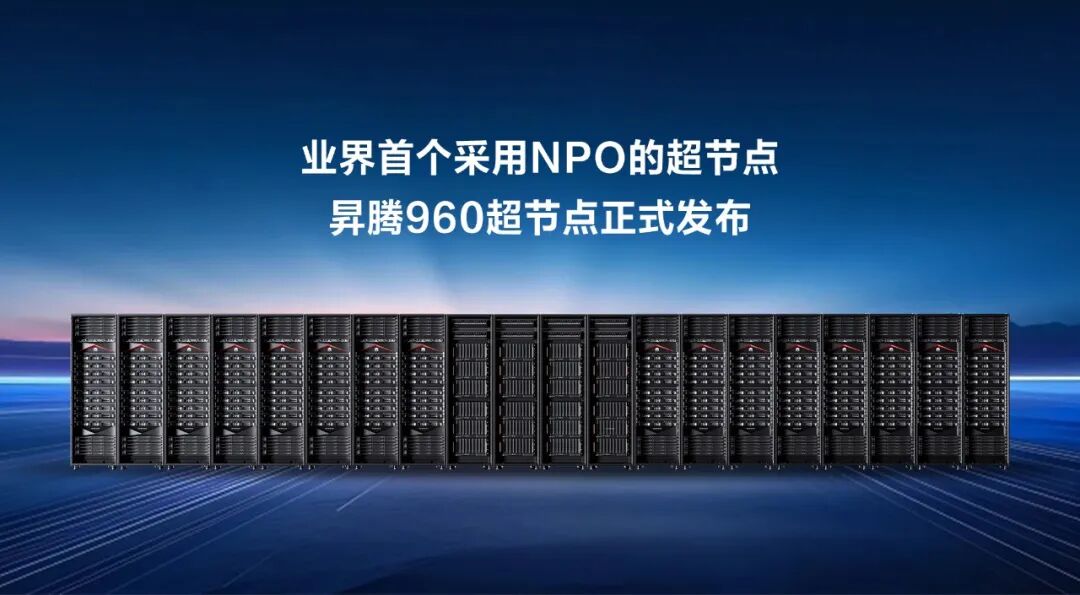
依托这一突破性的光互联技术,搭配全新的昇腾960芯片,华为正式发布了全球首个采用 NPO 技术的超节点 —— 昇腾 960 超节点。这款超节点采用领先的正交架构和全液冷设计,基于灵衢实现内存统一编址,单个超节点即可扩展至4096卡规模,可提供 8EFLOPS FP8、16EFLOPS FP4 的澎湃算力,以及高达 1PB 的 HBM 容量,可充分支撑十万亿级大模型的训练与推理需求。
更具商业价值的是,昇腾960 超节点仅用 5500 个 Hi-ONE 光引擎,就替代了传统方案中需要的 4.8 万颗 800G 光模块,这直接为企业大幅降低了部署与运营成本:仅系统功耗就降低了超过 550 千瓦,同时系统无故障运行时间提升一倍,系统可用度达到 99.8%,大幅减少了企业的运维投入。
除了面向智算场景的超节点升级,华为还将这一先进架构引入通算系统,推出了全新升级的鲲鹏超节点,为当前火热的Agent 应用提供更强的通用算力支撑。基于灵衢全光组网,鲲鹏超节点最大支持 4096 节点,可形成 256TB 的统一内存池,在 Agent 场景下,十万级别沙箱启动速度相比传统方案提升 30 倍,沙箱密度进一步提升 25%;在百亿千维的复杂向量检索场景下,检索效率实现倍增,让企业部署 Agent 应用的成本与门槛大幅降低。
针对Agent 与长序列推理场景下的缓存需求,华为还同步推出了配套的存储解决方案 ——OceanStor M900 集群,进一步补齐了超节点系统的存储能力短板。这款基于灵衢 UnifiedBus、支持“一跳直连” 的 L3.5 层 PB 级 KV 缓存解决方案,采用混合介质加优化 Retention 算法,可将 SSD 读写寿命提升 16 倍,从底层保障了长序列推理的长期稳定运行。
而这些不同的算力、存储单元,最终通过灵衢UnifiedBus 统一互联技术实现了高效协同,将昇腾超节点、鲲鹏超节点、KV 缓存集群等子系统实现平等互联,消除了协议转换开销,让整个系统真正成为一个有机的整体。通过二层 CLOS 四平面组网,该集群最大可实现 51.2 万卡的规模,结合多轨道拓扑技术,最大可支持 100 万卡昇腾超节点集群,彻底打破了传统架构的规模天花板,为百万亿级大模型的研发提供了充足的算力空间。
汪涛表示:“华为 AI 战略的核心是算力,我们坚持围绕‘超节点 + 集群’,通过系统架构创新构建竞争力,打造中国坚实算力底座,为世界构建新的选择。”
生态跨越拐点
开放平台释放全球产业价值
在汪涛看来,技术的价值需要开放的生态来充分释放,构建开源开放的算力生态是华为的核心战略,只有这样,才能让“超节点 + 集群” 的新选择真正惠及全球的开发者与产业伙伴。
目前,CANN社区已成为中国开源项目活跃度第一,鲲鹏生态已成为全球数智化创新的重要支撑,全球开发者超过416 万,生态合作伙伴超过 7200 家,支持了 560 多个全球开源项目,其中 openEuler 操作系统的装机量已超过 2000 万套,成为中国服务器操作系统市场份额第一的产品,为整个算力生态打下了坚实的基础。
与此同时,作为昇腾生态的根基,CANN 已全面进入常态化的开源社区运作,目前,CANN 的外部开发者占比已达到 61%,首次超越内部开发者,社区月活开发者突破 5200 名,成为中国最活跃的开源社区。这意味着昇腾生态已经从华为主导,转向产业共同建设的开放平台。
据介绍,基于昇腾+ CANN 的原生训练模型已超过 40 个,昇腾也已覆盖 90 多个主流第三方社区,包括 PyTorch、Triton、vLLM、veRL 等,让开发者能够更便捷地基于昇腾平台开展创新。更值得关注的是,在 Linux 基金会的支持下,昇腾已正式成为 PyTorch 官网可直接安装的算力平台,也是首个来自中国的算力平台,这意味着全球所有开发者都可以更便捷地获取昇腾生态的创新成果,华为的算力平台正在真正走向全球。
值得注意的是,此前,国内AI 算力生态长期面临 “生态绑定” 的市场质疑,而昇腾生态的发展,恰恰打破了这一质疑:外部开发者占比首次超过内部,意味着生态已经脱离了企业的单轮驱动,进入了产业共建的自循环阶段。而 PyTorch 的官方支持,更是打通了华为算力平台与全球开发者的通道,这意味着华为的 “新选择”,不再只是面向中国市场的选项,而是能够服务全球开发者的通用算力平台。
“人工智能也许是人类社会最后一次技术革命,它带来的变革之深、之广、之快,远超想象,没有任何一家公司能独自支撑整个智能世界。” 汪涛强调,华为将持续聚焦 AI 基础设施,坚持打造智能世界的硅基黑土地,坚持软件开源开放,坚持拥抱百模千态,坚持合作共赢,携手产业伙伴共同构建万物互联的智能时代。
(来源:中国经营报 编辑:张明艳)