当CPU重回舞台中央:海光的“双芯”新棋局
来源:中国基金报

【编者按】“十五五”时期是我国迈向2035年基本实现社会主义现代化目标的关键一程。为此,《中国基金报》推出“开局起步‘十五五’:中国企业成长录”大型主题报道,跳出成绩综述模式,走进一批领军标杆企业,记录它们在技术攻关、产业升级、资源博弈中的真实考量、路径选择与转型阵痛,以微观案例呈现中国经济的韧性与活力。
本期,《中国基金报》专访海光信息总裁助理兼智能计算产品部总经理杜夏威,请其详细阐述海光信息在“十五五”新的战略谋划和技术跨越。
中国基金报记者 尹振茂
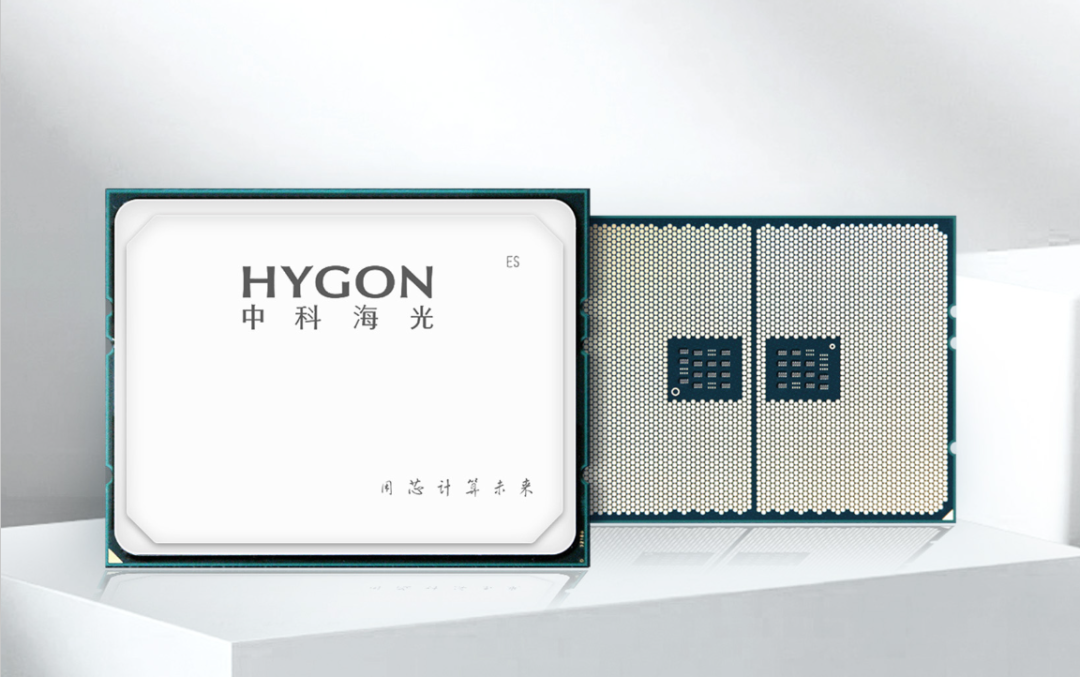
在国内头部芯片公司中,海光信息是少有的在CPU和AI芯片两大赛道都具备较强实力的选手,也是少数在“双芯协同”与“开放生态”两方面同时下注的大玩家。
9月22日下午,基于端侧算力正成为驱动物理世界数智化转型的关键基石这一产业大趋势,海光信息正式发布海光CPU 1000系列——首款面向低功耗、嵌入式和端侧算力需求打造的海光C86架构处理器;公司同时表示,其在嵌入式市场中的价值定位并非单一芯片销售,而是希望成为“生态、安全、稳定的长期合作伙伴”。
显然,在人工智能进入Agent时代之后,在CPU重回计算舞台中央之际,海光信息的“双芯协同”和“开放生态”战略,又迎来了新的机遇、跨越和挑战。
日前,中国基金报记者专访了海光信息总裁助理兼智能计算产品部总经理杜夏威,请其详细阐述公司在新的历史机遇下的“双芯战略”、海光AI芯片(DCU)刚刚完成的里程碑式的新跨越,以及打造开放软件生态的战略和路径。
“双芯战略”新机遇:当CPU重回舞台中央
要理解海光的战略,需要先理解一个正在被行业重新校准的认知:在AI Agent时代,CPU的角色正在发生根本性的变化。
在行业早期的大模型推理场景中,算力消耗几乎全部集中在AI加速芯片上,CPU被压缩为一个“数据搬运工”。但随着AI Agent和多智能体应用的规模化落地,这一格局正在被颠覆。
在2026年8月的投资者交流中,海光信息援引产业数据指出,智能体完整运行链路中,模型结果解析、工具调用决策、API交互调度、任务流程编排、安全策略校验等多数环节均依赖CPU承载,海外头部CPU厂商实测显示,超七成智能体运行流程落地在CPU侧。伯恩斯坦的研报进一步量化了这一趋势:在智能体工作负载中,CPU的计算占比将从传统大语言模型的14%跃升至50%。
这意味着算力基础设施的竞争逻辑正在从“AI芯片的单点性能”转向“CPU与AI芯片的协同配比与系统调度能力”。海光的“CPU+DCU”产品架构,恰好精准匹配了这一产业趋势。
对此,杜夏威有清醒的判断:“伴随着Agent的发展及Token的高效普及,CPU发挥作用的空间也越来越大。不过,对于CPU重要性的提升,我们不能简单地将其解读为CPU与GPU之间的此消彼长。”他强调,总体需求一定在不断增长,CPU和GPU的需求都将大幅提升,只是CPU将在其中扮演越来越重要的角色。
这种判断建立在一个朴素但坚实的第一性原理之上:从根本出发,尽可能满足上层需求发展。海光CPU负责业务逻辑管控、多智能体协同调度、数据预处理等通用负载,DCU则专注模型训推加速。
更值得关注的是海光在系统级互联层面的布局。作为海光双芯战略的技术枢纽,HSL高速互联协议有机地将CPU、DCU以及扩展主存显存乃至后端IO设备组织在一起,杜夏威将其定位为“为上层开发者和大模型的迭代演进提供更加便捷的传输和访问通道”。2026年,HSL协议已从最初的芯片间互联演化为涵盖Scale Up纵向扩展与Scale Out横向组网的双重互联体系。
杜夏威特别强调了HSL的开放属性:“HSL协议的开放也为不同芯片的组合提供了更多想象空间。这既包括海光的CPU与海光的DCU,也包括不同的CPU芯片或者AI芯片之间的灵活组合。”
这种开放姿态,与国际厂商通过NVLink和InfiniBand构建专有互联生态的策略形成了鲜明对比,也构成了海光在系统级竞争中差异化定位的基石。
里程碑式的跨越:从“能用”到“好用”
2026年,海光DCU完成了一系列令人瞩目的Day0适配:月之暗面的Kimi K3、智谱的GLM-5.3、腾讯Hy4 Preview、MiniMax H3……国内头部大模型厂商的旗舰产品发布当日,海光DCU即完成全栈适配与性能验证。
值得注意的是,近期国内某头部大模型厂商刚刚发布新一代旗舰开源模型,海光信息DCU的Day0大规模适配就随即完成。
在上述信息中,需要关注的不仅是速度,更重要的是“大规模”和“好用”。
对此,杜夏威表示:“海光DCU不仅追求‘发布即可用’,更追求‘发布即好用’。从可用到好用的跨越,其评价权不在芯片厂商,而在开发者和用户。”
“此次适配成功最核心的里程碑意义在于,无需再讨论海光DCU的兼容适配或者优化效率,而是其发布之初便具备线上支撑业务的标准和能力;用户直接调用相应的Token,而不再关注模型底座的芯片来源,以及适配与优化情况。”
这一判断有硬数据支撑。海光DCU Day0适配Kimi K3的实测显示,国产卡性能折损控制在12%以内,已达到商用部署标准。针对KDA注意力和896专家MoE架构,海光完成了算子级定制优化,即使在百万级上下文的重载场景下,896个专家并行工作的推理依然高效稳定。
目前,海光信息的DCU产品已覆盖20多个关键行业、300余个应用场景,与DeepSeek、Qwen3、智谱等400多款主流大模型完成全面适配与联合精调。从十亿级端侧推理到千亿级模型训练,海光DCU已具备全场景支撑能力。
杜夏威将这一跨越的实现归因于一个朴素的工程哲学:“我们在前期与伙伴推动相关前置和深度的联合研发,从而保障不仅发布即可用,而且发布即好用。”
这种“前置联合研发”的模式,本质上是在芯片设计阶段就与需求方深度耦合,确保流片出来的产品能够与大模型为代表的热点技术在时间节点上精准契合。通过与大模型厂商的早期深度耦合,保障在芯片设计之初就能与需求用户做好充分沟通,最终尽可能缩减芯片产品与模型产品之间由于不同迭代周期可能带来的阻碍。
兼容是“点火”自主才是飞轮
如果说芯片性能决定了海光的“下限”,那么,软件生态将决定其“上限”。
在此次专访中,杜夏威这样概括海光的生态哲学:“兼容更类似于飞轮的‘点火’启动,但未来的高速循环和快速旋转一定是依赖于自主生态的良性迭代和自发推动。”
他以飞轮效应为框架,将海光的生态建设划分为两个阶段:兼容阶段以降低开发者迁移成本为核心目标,自主阶段以构建原生生态为终极方向;最大的技术难点在于如何让飞轮开始转动,“启动阶段是我们最关注和最艰难的时期”。
2025年底,海光宣布全面开放DCU软件栈核心技术,与AI芯片厂商等产业伙伴共建软件栈生态标准。
杜夏威透露,2026年海光将逐步把整个DCU软件栈进行原生开源,“通过众人拾柴的方式,最终让整个海光生态繁荣起来”。
在生态组织层面,光合组织已汇聚超过6000家合作伙伴,覆盖芯片设计、整机制造、AI软件、行业应用等全产业链环节。
据杜夏威透露,光合社区的问题与内部即时通讯工具联动,每条用户评论都会直接传递到后台社区运营人员与技术专家的电脑上。这种“需求采集-内部响应-技术迭代”的闭环,本质上是在构建一个以开发者需求为驱动的生态飞轮启动机制。
“这是我们在整体生态发展方面,尤其是针对开发者生态方面一个非常重要的举措。”
海光路径的独特性还在于其开放架构的底层逻辑。杜夏威强调,HSL协议为整个业界提供了开放架构的表率,“可以保障产业链条中不同位置的伙伴都能够从HSL协议中获益并得到助力”。在芯片协同合作方面,海光与更多芯片厂商开展深度协作,CPU可以与多种AI芯片结合,DCU也可以与多种CPU结合。这种“不绑定”的开放姿态,在短期商业利益上可能不如封闭生态的锁定效应来得直接,但从长期来看,当算力系统从“单芯片”走向“机架即计算机”的集成范式时,开放互联协议的生态价值将被重新定价。
英伟达用二十年证明了软件生态可以成为最深的“护城河”,而海光正在尝试用“开放”来回答同一个问题:在AI Agent时代,当CPU重新成为算力调度的中枢,当互联协议而非单一芯片性能成为系统效能的关键变量,一个开放的、双芯协同的生态体系,能否走出另一条路径?
杜夏威给出的答案是务实的:“我们的兼容更多是为了保障自主的生态和开发者的逐步积累,逐渐推动国产自主生态的飞轮效应循环。”兼容是起点,自主是终点,而飞轮的转动,需要每一个开发者的助力。
编辑:江右
校对:纪元
制作:鹿米
审核:陈思扬
版权声明
《中国基金报》对本平台所刊载的原创内容享有著作权,未经授权禁止转载,否则将追究法律责任。
授权转载合作联系人:于先生(电话:0755-82468670)
(来源:中国基金报 编辑:骆一帆)