21专访丨松延动力创始人、董事长姜哲源:把机器人做到足够便宜,还要让它真正干活
姜哲源语速极快,意气风发。作为当红具身智能公司的创始人,这位28岁的创业者极具个人风格,对话中他常常会抛出“我说一句暴论”,后面紧跟着就是行业里没人愿意讲的真相。
比如,能批量交付高质量、产品级本体的机器人公司,他认为“目前整个市场不超过五家”;关于机器人为什么干活慢,他说“这事我觉得纯粹能力问题”;谈行业格局,他的判断是“终局肯定是赢者通吃”。至于机器人什么时候能买回家就开始做家务,他给出了一个相对乐观的预期:“也许再过几年,就有可能在泛化场景下完成特定工作。”随后他又补了一句:“这不是一个结论,只是我个人的一点猜测。”
近日,21世纪经济报道、21Tech记者专访了松延动力创始人、董事长姜哲源。这位1998年出生、在清华读博期间离校创业的年轻人,已经带着公司上过了央视春晚,把机器人本体做到足够便宜可靠。今年,他带着团队开始重金投入机器人大脑。
2026年,人形机器人行业的叙事有一个明显变化,几乎所有主流玩家都要证明,机器人到底能不能干活。智元、宇树、松延动力都在加码机器人大脑。
9月,松延动力短时间内连续宣布了三项新进展,并且瞄准的都是行业难题:世界模型HERON-World Model让机器人理解、学习世界,HERON-CRA模型让机器人能记住过去、从错误中学习,HERON-Spatial Intelligence空间智能模型为机器人搭建可交互、可训练的世界。最终要实现的目标是,给机器人换一个环境,换一种物体,甚至换一副身体,它依然能把事情做好。
被问及松延动力是不是改了路线、为什么要做大脑、为什么是现在开始做,姜哲源的回答很坦诚:“我们一直的决策都是一定要自己做大脑,只是以前不到时候。”
2023年创业时,更紧迫的事是先把身体和运动控制做好,彼时大脑研发的技术方向还比较分散。现在,按他的判断,技术路线的大方向已经有了一些共识,本体也已经准备好。在成本和可靠性上,“松延动力在一些方面或许比行业整体稍微领先一点,现在,我们能做的准备基本都做好了。”姜哲源说。
外界认识松延动力,往往从一台运动能力出色的机器人开始。2025年北京亦庄人形机器人半程马拉松上,N2“小顽童”拿到亚军。到了2026年,这家公司的机器人又出现在央视春晚小品《奶奶的最爱》中,与蔡明同台。运动能力、舞台表现和价格,成了它最容易被记住的几个标签。
2025年10月,松延动力推出小尺寸人形机器人“小布米”,限时预售价格9998元。这个价格把机器人带到了一个更接近家庭消费决策的位置。它依然不是一个家务助手,公司的定位主要是儿童编程教育与陪伴,但购买者开始从学校、科研机构扩展到普通家庭。
姜哲源的创业起点是清华,他本科就读于清华大学电子工程系,之后进入交叉信息研究院攻读博士。2023年,博士第三年,他离开校园创业,松延动力于当年9月成立。
他的表达带着很强的个人色彩,讨论机器人未来替代工作话题时,他说如果哪天小布米能坐在这里替他开会,“那我会挺开心,正好开车去西藏走走”。
姜哲源把下一道关口称为泛化。简单说就是,换了身体、场景、物体和操作方式,机器人依然能做,而且有很高的成功率。他不认为仅凭几个好看的演示就跨过了这道关口。在他看来,真正的较量会落到数据上:能不能持续得到机器人需要的经验,能不能把这些经验整理、标注、用于训练,再用新模型产生新的经验。
在姜哲源的设定中,松延动力的路线是先把机器人本体做到足够便宜、可靠、能批量生产交付,这样就能大规模部署到真实场景中,让机器人在实际干活中积累大量真实世界的操作数据与经验;再用这些规模化数据训练大脑,达到真正的智能。
机器人最终要学会的,是走进一个从未见过的家庭,能收纳陌生的衣服,遇到有人挪动杯子,也知道接下来该怎么办。
为了完成这个终极任务,今年公司把很大一部分投入转向大脑研发。姜哲源觉得,虽然融资不错,钱还是要紧着花;同时,本体业务还可以承担造血任务,让今天能卖出去的机器人支撑明天可能到来的智能。
他对机器人未来的想象很远,对当下的判断却十分清醒。被问到机器人行业这场马拉松究竟跑了多远,他仍然觉得,还不到十米。
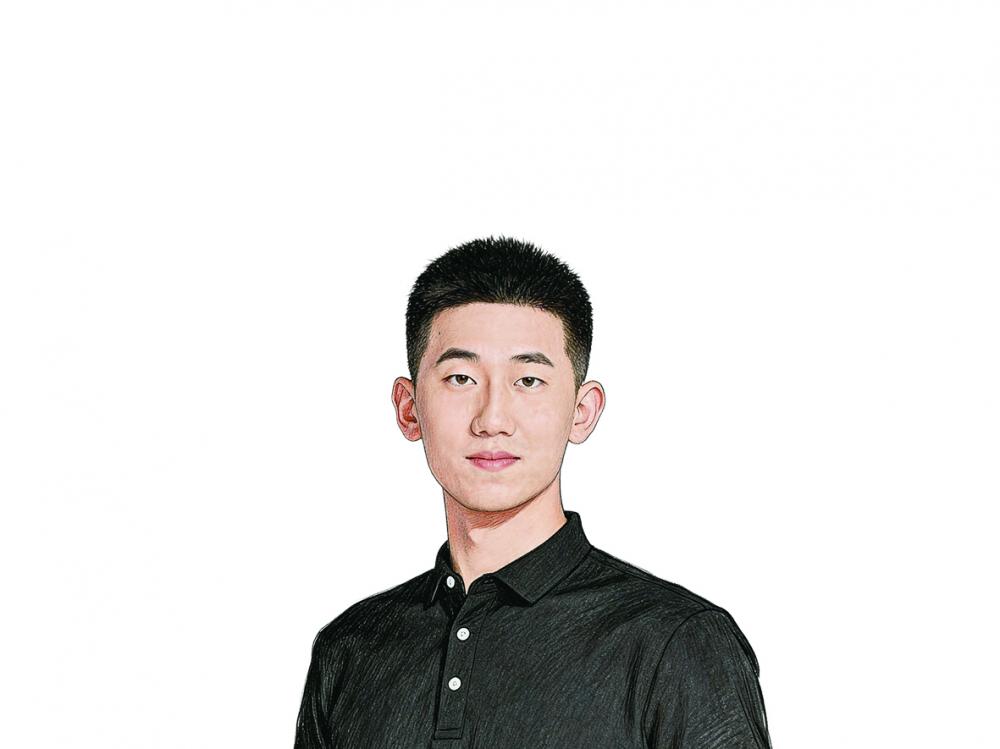
姜哲源。资料图
现在“下死手”做大脑,一切准备好了
《21世纪》:松延动力以前更擅长本体,现在决定自己做大脑,决策点是什么?
姜哲源:我们一直的决策是一定要自己做大脑。但是我们确实之前没有正儿八经去下死手做大脑。
今年为什么决定去下这个死手?是因为我们看到整个技术路线,大方向大家已经有一些共识了。只是一些细节的地方,每家有各自不同的方案。在这种时候,我们觉得是可以投入做了。
另外,我们也是觉得我们本体已经准备好了。我们的本体已经能做到成本极低,可靠性极强,做到了一个可能前所未有的程度。在这样一个大背景下,我觉得我们是需要大投入做大脑的,我们的一切准备好了。
《21世纪》:转向大脑会不会有点晚了?
姜哲源:全世界有太多大脑,但是目前,整个市场,真正能够批量化、规模化造出可靠的、能用的、产品级的本体机器人公司,绝对不超过五家。
本质上,大脑是不可能脱离机器人本体而存在的。我们今天处在一个数据驱动一切的时代。数据需要规模化,需要有很好的多样性。我认为很大一部分数据是不能脱离本体存在的。
有本体批量规模化制造和低成本制造能力的公司,我认为会在数据的规模化这方面有着难以比拟的优势。反而我不觉得现在这个时间点晚,我觉得这时间点正好合适。
《21世纪》:做大脑会有哪些坑?
姜哲源:主要是四个坑,一是依赖真机数据;二是绑死单一本体,换台机器人就不会干活;三是只在仿真里做;四是只做演示,不做数据基建。
机器人行业不需要那么多公司,一定是“赢者通吃”
《21世纪》:从去年到今年,行业最大的变化是什么?普通观众好像从WRC、WAIC上没看见特别大的变化。
姜哲源:看WRC、WAIC,能看到的变化是有限的。今年有几个不一样的地方。
硬件本体运动能力逐渐平权了。去年WRC上,极少有公司展示非常高动态的能力,我们算是为数不多的一个。今年各展台高动态能力展示都挺多了。
大脑侧,去年很少看到真正展示作业场景的,今年也看到了。在展览之外,机器人本体成本、可靠性、普及度,都在逐步向好。这些都是行业高速发展比较好的信号。
《21世纪》:今年的竞争重心是不是变了?
姜哲源:每个阶段在不同层次、层面竞争。大家一定是殊途同归,希望去到有通用具身大脑的机器人时代。在这个时代到来之前,每年竞争格局会不一样。
去年可能主要拼运动能力、出货量、盈利能力,包括本体做得有多炫。今年运动能力也不是什么核心比拼项,因为大家都已经到一个很高的程度。今年更多拼规模化、大脑、全身运控、感知运控。
《21世纪》:长期来看,行业会形成怎样的格局?
姜哲源:这个行业确实不需要那么多家公司。资本市场相对冷静之后,肯定有一些公司掉队。
终局,肯定是赢者通吃这样的市场。因为赢家能够获得最好的数据闭环。一旦形成飞轮效应,越做越好,后面的人不好打破。推动也难,但一旦进入这种阶段,就越转越快、越转越好。
《21世纪》:谁能成为那个赢家?
姜哲源:我觉得还是选对路线,选择正确的数据采集路线,沿这个方向投入,采到真正需要的数据,训练一个有足够好泛化性的模型。
机器人里面,我觉得看谁能最先开始往家里卖,谁能先在家里面卖爆。
《21世纪》:大模型或世界模型公司也可以买本体采数据。你们的优势在哪里?
姜哲源:第一,我们成本低,不一定卖得便宜,一定会有资金上的缺口。
第二,做数采不只是一个本体的事情,是一套很复杂的解决方案。人的数据怎么采,有没有专门设备?采完的数据怎么落盘、怎么存、怎么传回来、怎么标注?管线是一个成链路、成体系的能力。
除了本体成本之外,别的部分我觉得是可复制的,但也是认知差和时间差。
我们非常欢迎基模公司找我们大规模采购本体,也以开放心态,愿意和大家一起共建数据集。我们并不奢望一定只有我们一家实现通用具身智能,希望整个行业一起往前发展。
现在刚从L0走到L1
《21世纪》:你所说的L0到L3,分别是什么?
姜哲源:L0是没有什么智能,纯粹是只会做动作的机器人。只会做动作、跳舞,没有操作能力。
L1是能够在一些特定场景下,在重交付情况下完成落地。什么叫重交付?针对每个工种,安排人去现场采数据、做训练、调优、部署,全套、全链路需要一个交付团队完成。这是我自己的定义,不是整个行业的定义。
L2是在泛化场景下,能够完成特定的一项工作。家庭是很典型的L2场景,买一个机器人回家,打开相应按钮开关,就可以帮我叠被子、收拾衣服,在特定几个任务上能够实现完全泛化。
L3是真正给它一个SOP(标准作业程序),给它一个图文并茂的讲解,它自己就开始干活,不需要做任何调优、交付动作。
《21世纪》:整个行业现在在哪个阶段?
姜哲源:我觉得整个行业现在处于从L0到L1这样一个阶段。L1级别的智能,我们自己都是有能力做的,能够交付一些场景。
真正无限接近天花板的是L2。能进家庭,所有的家都能买,这完全是不一样的天花板规模。
《21世纪》:王兴兴对机器人通用人工智能时刻所需年限的判断在不断延长。
姜哲源:我喜欢把问题定义清晰,通用人工智能时刻到底指L2还是L3?如果指L3,确实是十年以上周期的事情,因为需要的数据规模太大,要在各个不同领域不断攒。但对于L2,我觉得用不了那么久,相对会好做一些。
《21世纪》:这个行业的马拉松,现在还是只跑了十米吗?
姜哲源:其实也差不多。这个行业现在还没有什么真正特别规模化采集的本体数据。我觉得不到十米,依然刚起步。
我们的终点一定是L3,给机器人输入一个SOP,它对着SOP自己开始干活,不用任何调优,不用任何交付动作。这是最终极的梦想。距离这个梦想,整个行业发展的进程,可以理解为采集数据的进程,到底有多少数据,这离得太远了,十万八千里。
本体从十万元降到两万元,靠的是工艺
《21世纪》:本体准备好了,是及格了,还是已经拿了很高的分?
姜哲源:一个本体拿到及格分要满足几个条件。
第一个,它不该是耗材,这是及格最基本的基线。本体本身至少得用个一两年,不能坏,这是最底线的要求。
其次,它应该具有能够完成操作的能力。自由度得够,力气得够大,重复定位精度需要足够高,关节的间隙、背隙还需要足够小。
第三点,底层运控需要支持你去完成这些操作。我们希望它能够支撑去做操作任务。这几个事情做完了,就是完成及格分。
剩下你说80分、90分,哪个更好,我们会有不同评价指标。有的人回答可能是更多传感器,比如全身的皮肤触觉;有的人回答可能是可靠性更强。这目前没有定论。
《21世纪》:松延动力的低成本靠规模吗?
姜哲源:不是,是靠工艺。在成本分析这个领域,有一句话说得很有道理,可能研发占80%,供应链或者规模占20%。真正能做到降本的研发,你的设计、工艺要占80%以上的比重。
比如从两万五千元降到两万三千元、两万两千元,你可能可以靠规模。但如果从十万元降到两万元、两万五千元,这事一定是靠工艺。
我们用了非常多不同的工艺。我们团队现在在这件事情上,其实在帮整个行业踩坑。
《21世纪》:你说制造优势会变成数据优势,怎么理解?
姜哲源:可以算一个很简单的小学数学。一个机器人本体,单位时间的使用成本,可以理解为包括人工在内,整个机器人制造成本,除以它可摊销的周期,就是硬件多久坏掉、多久不能用。
这里边有两个点。第一,你要能够低成本制造出能用的硬件;第二,你要制造出高可靠性的硬件。这两点是我觉得我们难以比拟的优势。
我们经历了今年C端交付以后,看到了C端用户用机器人的情况,也针对性做了非常多补强。我们还有批量制造机器人的能力。
《21世纪》:做大脑和降成本,是两种不同逻辑吗?
姜哲源:做大脑跟成本低这两个事,一定是相辅相成的。
一定要先把成本降下来,你不把成本降下来,后面的规模没得谈。成本降下来才能带来规模,规模才能换来规模化的数据,多样化的数据才能真正带来智能。
成本意味着你可以很自信地去放大规模。成本高的时候,我没有任何信心放大设备、机队的规模。但当成本足够低的时候,我们是可以无痛去做这个事情的。
本体要挣钱,大脑还得继续投
《21世纪》:现在收入主要来自B端还是C端?
姜哲源:金额上B端多,量级上C端多。
从幼儿园到K12,到高校、中职、高职,每个场景都有不同客户和合作伙伴案例。整个解决方案里不只有机器人,还有配套课程和服务。
今年B端收入增长里面,大头在教育,大教育场景。得益于过往积累,今年呈现出规模化的增长。
除此之外,在商业服务、文旅等场景,很多解决方案合作伙伴会基于我们的机器人二次开发,应用场景非常多样。多样性的场景应用、教育板块,以及C端的初步探索,构建了今年营收的盘子。
《21世纪》:既要做本体,又要做大脑,钱怎么分?
姜哲源:我澄清一下,本体是个买卖,是个生意。真正投入资金的成本部门,一定是大脑部门,而且是重成本部门,是要持续高强度投入的部门。
如果单拎出本体来看,今年我没算过,今年可能不一定。但明年,我觉得单拎出本体来看,可能还真是挣钱的,很有可能。如果把大脑部分全刨掉,很有可能整个公司是盈利的。
《21世纪》:小布米毛利不高,为什么还要花精力做?
姜哲源:品牌心智是要靠时间积累的。我们在京东平台最早上线布米的时候,店铺流量特别低。后来随着时间推移,一点点养起来。
在家庭端、C端,品牌心智要靠时间养起来。要持续种草、持续发声、持续有交付、持续让用户产生一些认知。
这个心智建立要花时间,不能等大脑好了再做。我们一定要做,要持续投入。
《21世纪》:投资人认可这套先做本体再做大脑的路线吗?
姜哲源:真金白银投了我们了,那还能不认可吗?
说服远小于选择。有的投资人可能就不想看做本体的公司,有投资人重看大脑,有投资人只看本体。我们更多选择能认可我们路线的投资者。
一个公司至少要先有一个能撑得起自己的业务,再谈星辰大海。具身公司比较棘手的一点在于,纯做大脑的公司,短期内很难有这种收入。所以在我看来,做本体不是一个选项,是必须要干的事情。
《21世纪》:现在行业里是不是大家也没有那么看重赚钱?
姜哲源:我们还是比较追求健康现金流,肯定不能一直依赖输血。希望公司能够有明确的盈利改善趋势。我们比较追求这个事,但确实整个行业现在大家看得不是那么重。
《21世纪》:融资之后,钱还紧吗?
姜哲源:即便融了不少钱,还是觉得钱紧。活着肯定没问题,但确实紧,得紧着花。
如果今天你给我账上足够多的钱,我可以铺出可能一万台机器人出去采数据,可能很快的时间,至少L2级别这事就实现了。
机器人干活慢是公司能力不行,最难的是泛化
《21世纪》:机器人干活为什么还那么慢?
姜哲源:这事我觉得纯粹能力问题。你们可以看我们的样片,跟人干活其实差不多,甚至有的比人干得快,这是能力问题。
《21世纪》:你以前对仿真数据持保留态度,现在变了吗?
姜哲源:我之前的判断一直是,我们不能全用仿真数据。仿真数据有用,但不能全用。今天依然是这个判断。
但确实,我们很多工作放在了怎么在仿真器里建立大量、多样化、优质的资产。我们有自己的数据配方,金字塔里面包含部分仿真数据。
《21世纪》:站在现在看,最被低估的是什么?
姜哲源:最被低估的,我觉得是硬件本体上的一些技术。很多人觉得硬件本体已经不是什么会有新突破的东西了,但我们可能会用后面一系列发布,证明本体上确实有一些突破。
《21世纪》:通用AI有人讨论减速,具身智能的发展到哪一步了?
姜哲源:我觉得具身智能需要加速。L3肯定非常远,等到了L3再谈这些事情。
机器人要学会自己判断下一步该怎么办
《21世纪》:最近在大脑侧连续推出的几个动作分别是解决什么问题的?
姜哲源:HERON-World Model是一个动作条件世界模型,给它当前画面和机器人将要执行的动作,它推演接下来世界会怎么变化。真正输出动作的是HERON-CRA。
世界模型可以作为策略的评估器和数据生成器,帮助降低真机试错成本。
可以参考我们发的CRA的样片。有两个样片,一个是叠袜子,另一个是做咖啡。
叠橘色袜子,最开始它发现夹爪没有夹得特别好,会自己做出一个调整,再重新把爪插进袜子筒里面,再去继续做。
咖啡那个,我们特意加了人工干扰。本来机械臂要拿打好奶泡的杯子去混咖啡,但工作人员连续两次把杯子挪到了别的位置。可以看出模型先做了停顿,然后重新调整动作方向,把任务执行下去了。
未来在家庭服务、商业服务等各类服务场景里面,或多或少会遇到这样一些问题。我们觉得得益于大脑技术能力的演进,这些问题是可以被当场处理、调整的。
《21世纪》:记忆、精细操作、跨本体泛化,哪一项最难突破?
姜哲源:真正难的,我认为还是通用的泛化能力。我们讲跨本体、跨场景、跨物体、跨使用方式,各种不同的泛化能力,这是最难的,因为这是最需要海量数据支撑的。
下一步肯定也是往这方向走。怎么样让机器人在不同场景下都能用,而且以很高的成功率用起来,需要海量、多样的数据,以及一些人机协同数据。
最终泛化考验的是最后的数据,我觉得是数据管线,包括数据基建做得怎么样。
在某一部分任务上,确实需要强调记忆能力。在另外一部分任务,比如简单的抓取与放置,就没什么需要记忆能力的。
扫描二维码查看专访内容
(作者:孔海丽 编辑:骆轶琪,骆一帆)
南方财经全媒体集团及其客户端所刊载内容的知识产权均属其旗下媒体。未经书面授权,任何人不得以任何方式使用。详情或获取授权信息请点击此处。