直言对AI信仰与日俱增,王兴兴、向少卿工博会对话
21世纪经济报道记者 张赛男
在2026年工博会的聚光灯下,两位机器人产业的一线操盘手坐到了一起。
一位是宇树科技创始人王兴兴,他让机器人先“动起来”;一位是禾赛科技联合创始人、大裂谷(Sharpa)联合创始人向少卿,他正试图让机器人“干活”。
两家机器人公司的同台对话,也是一次对行业核心命题的集中“拆解”:云端还是端侧?机器人何时真正进厂?落地场景从哪里开始?面对这些问题,两位机器人行业的掌舵人没有回避,也没有简单选边。
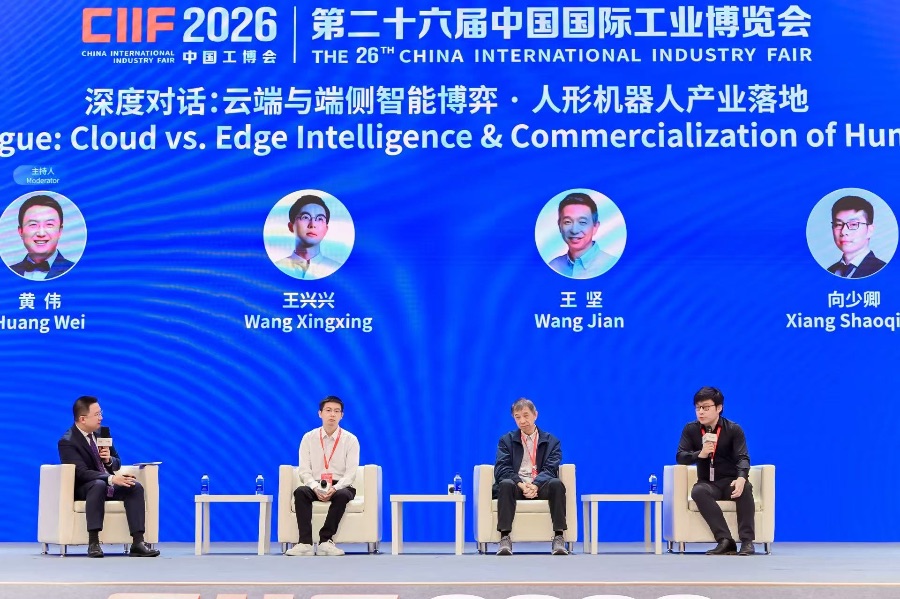 (工博会对话现场)
云与端:不是替代,是分工
云端智能和端侧智能,机器人大脑到底在哪里?这是近期机器人行业的热点话题。
对此,王兴兴表示,机器人本体的算力部署受空间、电池、散热等条件限制,“在机器人上能部署的算力相对有限,能放到云端的,尽可能放到云端。”原因在于,云端算力可实时调配,灵活性和管理效率更高;而机器人装了多少算力,就只能用多少算力。
但他同时强调,运动控制的实时性离不开端侧,因为一些运动能力的AI,本身算力要求并不是特别高。但决策性、大规模泛化场景的部署,还是得靠云端。如果能把模型做小放到端侧,当然最好。王兴兴认为,AI能力越强、机器人能力越强,反而越需要云端支撑。目前宇树采取基础版本加算力选配的方式,由客户根据需求决定端侧算力配置。
向少卿则给出“短期”和“长期”两个答案。他认为,短期3至5年,机器人大量“思考”的运算仍会在云端,但运动执行等对时延敏感的关键环节必须放在端侧。“物理是不会等你计算完毕的。”“时延对机器人至关重要,因此算力应尽量靠近机器人。”
长期则是看到了10年以后,当机器人进入千家万户,云端将面临巨大负载和带宽压力,算力会更多从云端进入端侧。“但无论短期还是长期,时延要求始终不变。”向少卿说。
物理AI自进化:真机数据完成闭环
在物理AI自进化问题上,王兴兴认为,自进化是非常重要的方向。语言模型和多模态模型的训练自动化程度已经很高,头部模型公司已接近实现自进化;但机器人AI模型的开发仍比较原始,由程序员写模型、测试人员测试、人工反馈、再迭代。
“这个链路完全可以用AI自动化实现:AI自己写代码、自己做训练、自己部署、自己测试,再由AI打分并迭代。”王兴兴表示,目前仍需人参与打分,判断动作好不好看、成功率高不高、是不是人真正想要的结果,但未来人的参与度会越来越低。
在数据燃料上,王兴兴认为,人类数据和真机数据都关键。海量人类数据很重要,但真正让机器人在物理世界中完成最后几厘米的操作、提高成功率,真机数据同样关键。宇树作为本体厂商,更关注机器人本体与物理世界接触的数据。对于工业数据开放,王兴兴回应称:“AI需要所有数据。”
向少卿将数据来源排序为:人类操作数据、仿真数据、真机数据,三者层层递进。人类操作数据隐含人类对世界运行机理和自身身体的认知;仿真数据可无穷扩展场景;真机数据最终完成闭环。
他强调,三者逻辑递进,但开发部署同时进行,不能跳过。人类操作数据多到一定程度后,会成为足够好的“种子”,之后更多数据将来自仿真和真机。
落地路径:商业服务或快于工业
王兴兴直言,全球机器人还没有大规模进入工厂。GPT-6发布后,宇树将其放到各种机器人上测试,效果非常不错。他认为,具身智能临界点未来会较快到来,快则一两年,甚至GPT-7出来直接“打穿”也有概率。
目前宇树等公司已在工厂试点,2024年已在好几家汽车公司落地,但大规模应用仍需提高泛化性和效率。“未来几年必然可以解决。”王兴兴说,商业服务场景可能比工业场景更快,居家场景则相对靠后。
他同时表示,自己对AI的信仰与日俱增,“过去十几年犯的最大错误,就是对AI以前相信得还不太够。”王兴兴把未来十年最重要的事归结为“尽可能拥抱和使用AI”。
向少卿则介绍了Sharpa的落地进展:与DQ冰淇淋合作,在真实门店接真实订单。其关键点有两个:一是不需要改造环境,机器人直接进入人的环境干活,这是泛化的基础;二是能够不间断干活,这是后续自进化和持续数据采集的前提。
产品层面,Sharpa发布了新一代灵巧手Sharpa Wave W02,更轻巧并具备全掌触觉;面向操作的具身机器人整机D01,采用移动式底盘,聚焦灵巧操作,运行稳定、负载能力强、手臂速度快、精度高,并覆盖全身触觉;真机数采设备AE01;以及灵巧操作模型CraftNet。向少卿称,公司理念是“让机器人干有用的活,把时间还给生活”。
他对机器人泛化和商业化的定义是,机器人本身具备足够高智能。机器人进入新场景后,都不需要AI博士,场景运营者用工具稍作训练、采少量数据,就能让机器人很好地干活。下一步,Sharpa将在餐饮、零售、酒店三大场景部署3万台机器人。
(作者:张赛男 编辑:郑世凤)
南方财经全媒体集团及其客户端所刊载内容的知识产权均属其旗下媒体。未经书面授权,任何人不得以任何方式使用。详情或获取授权信息请点击此处。