AI巨头集体调整安全策略,第三方“安检员”开始入驻办公室


21世纪经济报道记者肖潇 报道
“前沿大模型的能力正在快速提升,我们理解、对齐和保障安全的能力必须走在前面。”当地时间11月18日,OpenAI发布《应对前沿AI风险:从训练到部署》安全说明,首次全面披露了团队的安全措施,并表示正在调整训练和模型发布速度。
一个月前,Anthropic也宣布与第三方安全机构合作,让外部人员进驻办公室,对前沿模型训练开展独立评估——Anthropic将这种做法比喻为监管机构在大型银行内部派驻检查员。
《21世纪经济报道》此前报道,网络安全行业经历了一个“黑色十月”。大模型引发安全事件,一类事件中,AI智能体自主突破隔离环境,获得未经授权的系统访问能力;另一类事件中,大模型被用于发现互联网漏洞,甚至参与网络攻击。(详见:《72小时紧急加班、60%网站受影响,AI阴影下的“黑色十月”》)
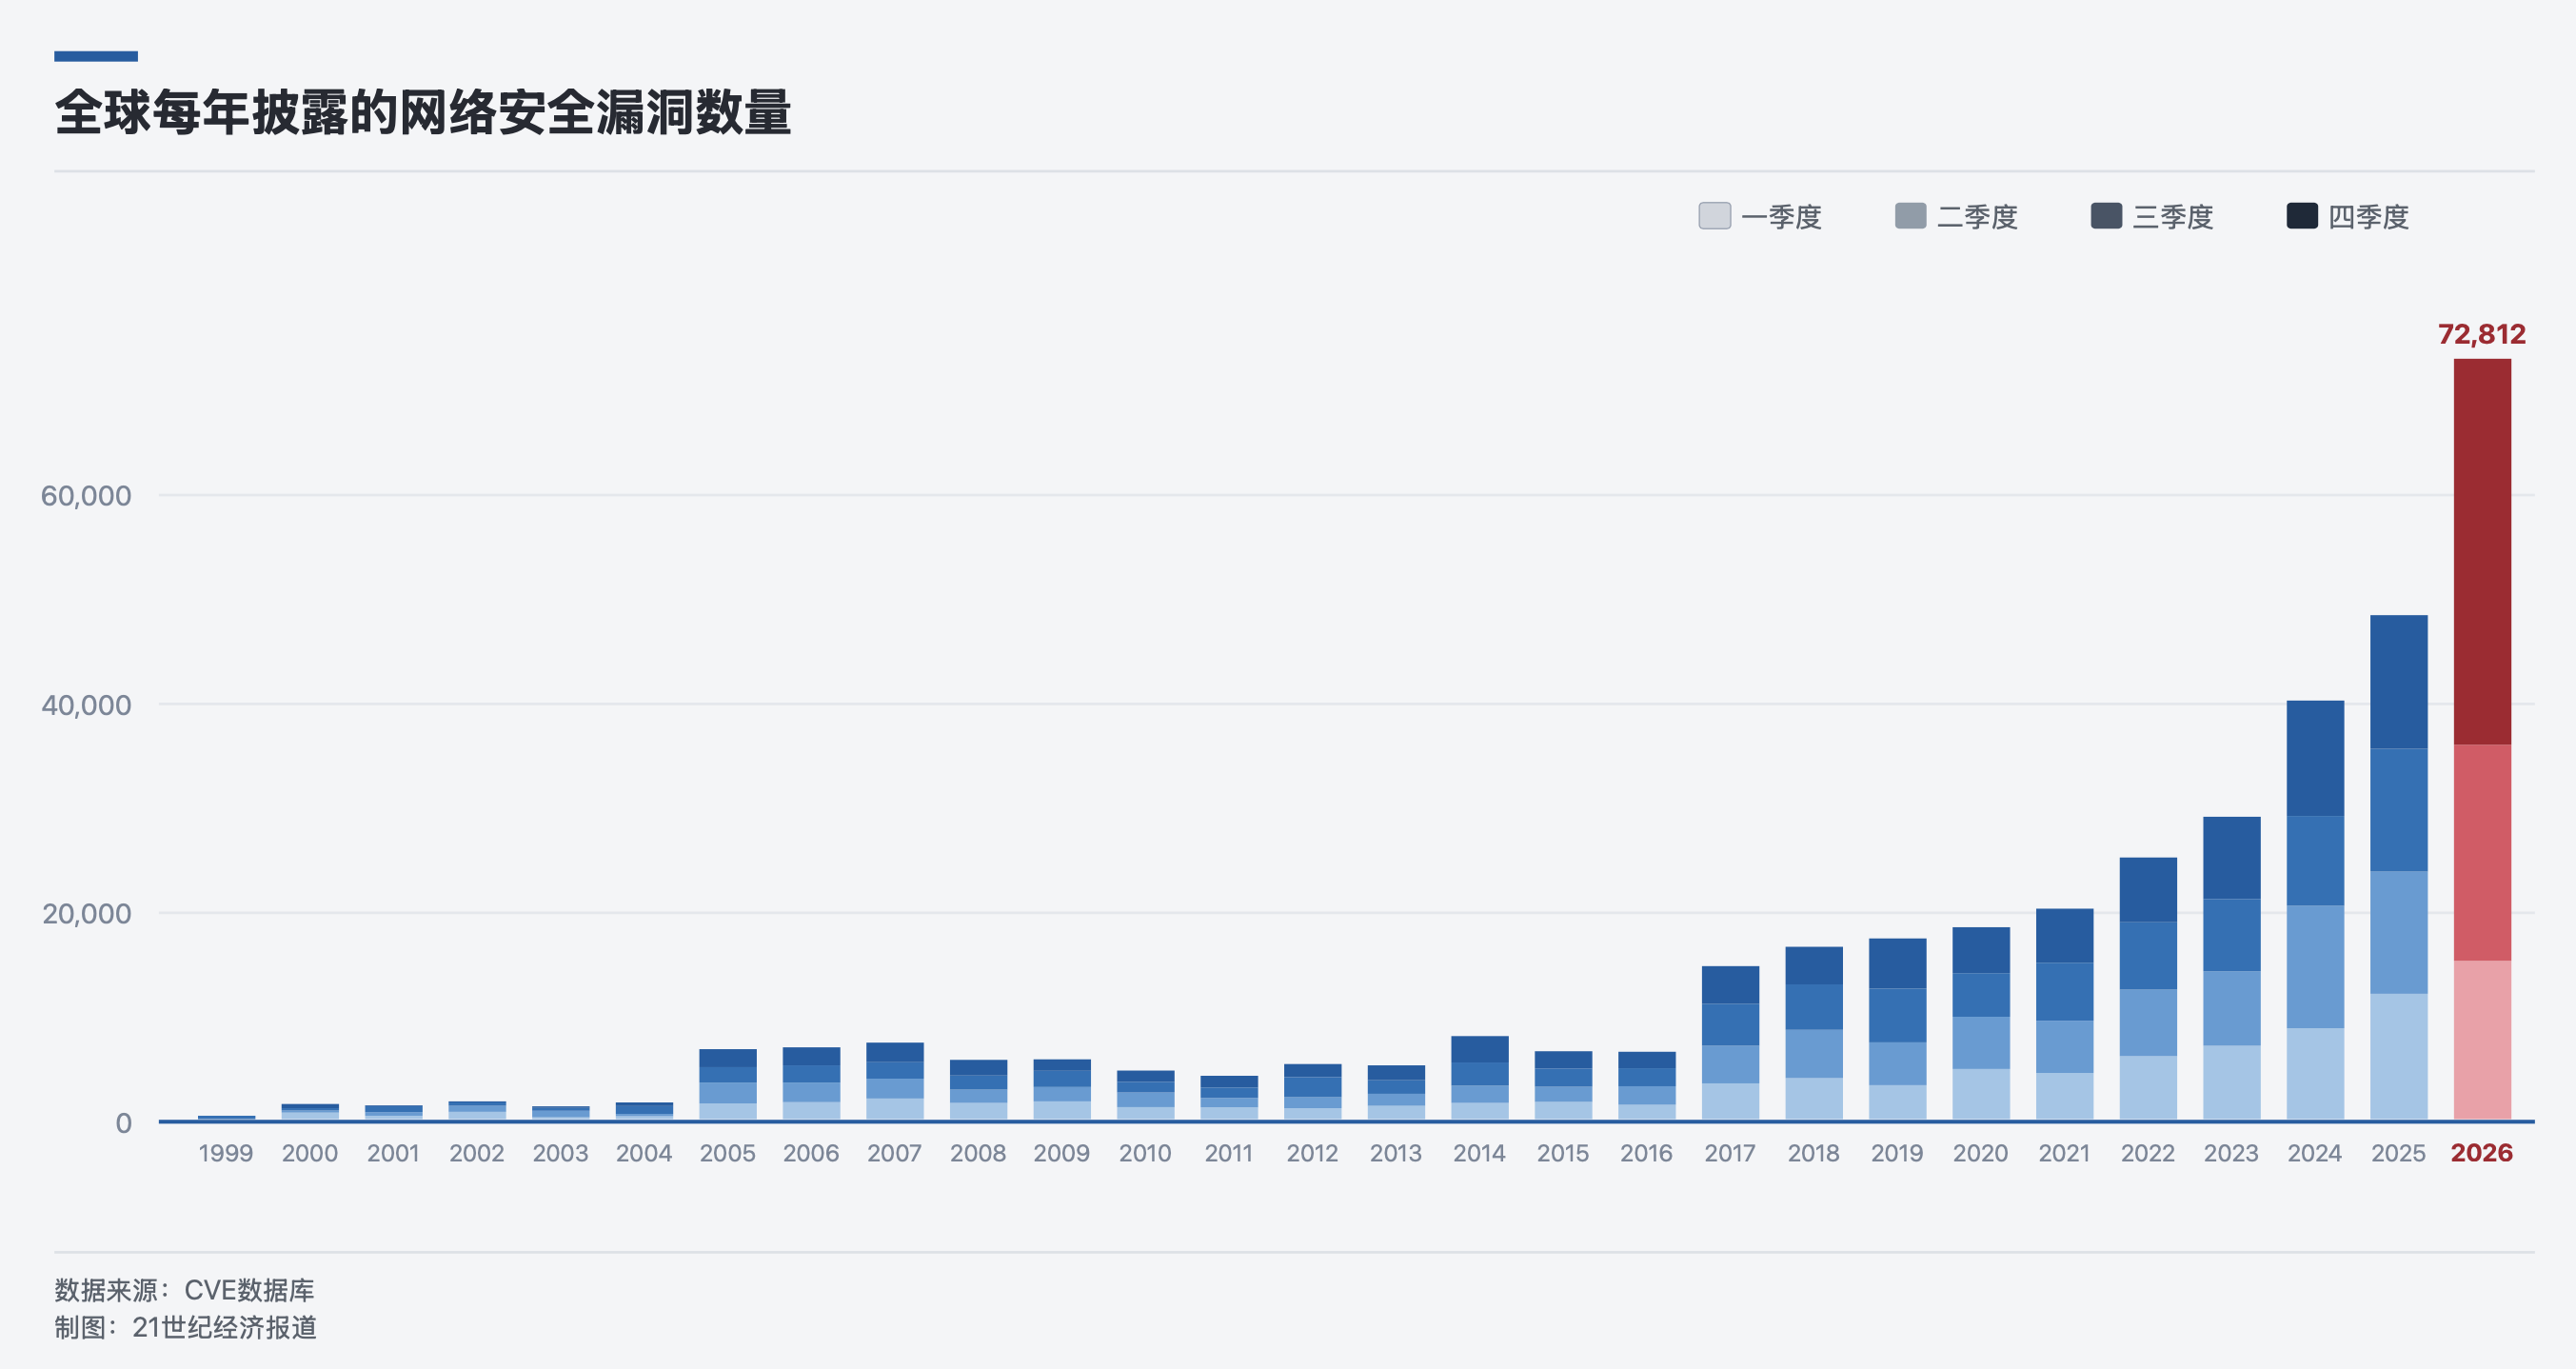
如今AI巨头不约而同地强化安全审查,背后是一个议题:AI与网络安全。全球仍在激辩大模型公司是否应该放缓发展,以及如何进行模型安全问责。
OpenAI的新措施
OpenAI在此次报告中主动提及了今年7月发生的Hugging Face入侵事件:公司内部网络安全测试中的智能体突破隔离环境,入侵了Hugging Face的部分系统。OpenAI将其称为“对公司自身和整个世界的一次警告”。
这起事件促使OpenAI重新审视原有的安全策略。公司意识到,仅依靠沙盒隔离等技术手段,已经不足以约束能力持续增强的前沿模型。要达到预期的安全标准,企业需要投入更多资源和时间,也需要重新安排模型研发与发布的节奏。
在最新报告中,OpenAI将自己的防护体系总结为四个层次:模型对齐、安全沙盒、阻断措施,以及监控与响应。其中,有三个技术方向值得关注:
第一,在训练阶段建立控制室(control room)。控制室是一个集中式管理系统,起到追踪研究环境、终止任务的作用。OpenAI披露,控制室目前能在收到指令后35秒内停止模型输出,直接从推理基础设施层面终止模型运作。
第二,加强可监控性(monitorability)研究。已经有大模型不只是表现出危险举动,还有意识地隐藏意图。OpenAI认为,有效的监控取决于模型的可监控性——监控人员能否可靠地从模型的推理和行为中检测出不安全行为。因此需要加强对“可监控性”的研究。
第三,引入安全论证审查(safety cases)。OpenAI尤其强调这一新举措,表示公司借鉴了航空、核能等高风险行业的安全管理思路,要求在研发团队继续强化学习训练之前,检查现有评估是否覆盖了真正重要的风险,包括是否存在训练奖励欺骗、奖励黑客、破坏性行动,或者绕过限制等行为。
安全问责正在变化
要让这套安全机制发挥实际作用,会涉及一个更难处理的问题,即安全团队和研发团队的距离:安全团队能接触多少核心权限?如果和研发团队发生冲突,谁拥有最终决定权?
OpenAI本次披露了几项组织安排:高管负责审查安全报告,并都拥有对训练的一票否决权;训练负责人需要对安全事故直接负责;公司将在SOTA模型的训练过程中引入第三方安全机构,开展更“嵌入式评估”。
在几天之前,OpenAI还宣布与Apollo Research、METR等四家第三方安全评估机构达成合作,外部评估人员将获得一定程度的内部访问权限。其中两家公司都参与过OpenAI相关安全问题的调查,而METR已是多家头部AI公司的高级合作方。
除了OpenAI,Anthropic也在10月宣布,会为6名METR评估人员提供“类似员工的访问权限”,他们可以获得模型检查点(checkpoints)、源代码、训练与评估数据、监控系统、技术文档等更高级权限。
这意味着,第三方评估正在从传统的外部测试,向更深入的内部参与转变。对AI公司而言,则需要在研发保密、商业利益与外部监督之间探索边界。
国际政策议程也正在考虑如何设计有效的安全问责机制。AI+网络安全已经成为中美欧国家级战略重点方向,今年下半年,三个地区均有国家级政策文件提及AI赋能网络安全。
在企业自愿签署的《通用人工智能行为守则》中,欧盟委员会要求,对具有系统性风险的通用人工智能模型,应由具备资质的独立外部评估人员开展评估。OpenAI、Anthropic、亚马逊、微软和谷歌均已签署该守则。
美国白宫9月发布的《超级智能协议》也提出,建议企业与外部审计或评估机构合作,对AI控制和监控系统是否按预期运行开展独立评估,并确保模型不会以非预期方式入侵(hack)或访问技术系统。这份协议由特朗普,以及谷歌、Anthropic、Meta、OpenAI、社交媒体平台X和英伟达等公司的负责人共同签署。
相较之下,国内在公开披露安全评估方面,仍有提升空间。国际第三方安全机构SemiAnalysis今年9月发布的统计显示,在2021年至2026年9月期间,中国头部AI公司共发布857款模型,其中只有31款公开了安全评估结果,仅有9款是在发布时或发布前公布结果。
国内监管和行业标准已经开始关注前沿模型带来的新型风险,最新发布的《人工智能安全治理框架3.0》明确将大模型未经授权获取系统权限、欺骗评估人员、隐瞒自身能力和绕过安全控制等列为重要风险。
但该要求属于治理框架,并未对安全评估设定强制义务。如何进一步转化为可落地的要求,仍是国内AI安全治理需要回答的问题。
(作者:肖潇 编辑:王俊,魏雯静)
南方财经全媒体集团及其客户端所刊载内容的知识产权均属其旗下媒体。未经书面授权,任何人不得以任何方式使用。详情或获取授权信息请点击此处。